統計的仮説検定の全貌!P値の罠と初心者が陥る落とし穴をプロが解説
データドリブンな意思決定が当たり前となった2026年、ビジネス現場や研究開発の最前線で再び脚光を浴びているのが「統計的仮説検定」です。AI分析ツールがワンクリックで美しいグラフや分析結果を出力してくれる時代だからこそ、その背後にある数理的な根拠を正しく読み解くスキルが、ビジネスパーソンの市場価値を大きく左右しています。
しかし現場では、「P値が0.05を下回ったから新施策の勝利だ」「有意差が出たから売上が伸びるに違いない」といった短絡的な判断による失敗プロジェクトが後を絶ちません。数字の表面だけをなぞる分析は、時に組織に致命的な損失をもたらします。今回は、多くの初学者がつまずきやすい概念を解きほぐし、データの本質を見抜くための実践的な思考法を整理しました。
📌 【この記事の重要ポイントまとめ】
- 要点1:統計的仮説検定は「差がない」という仮説を否定して目的の結論を導く、背理法に似た論理パズルである。
- 要点2:P値の盲信は禁物であり、第1種・第2種の過誤のバランスやサンプルサイズの影響を見極める視点が欠かせない。
- 要点3:ツールの自動出力に頼らず、効果量の確認や多重比較の補正を行うことが実務における意思決定の成否を分ける。
【基本のキ】帰無仮説と対立仮説の仕組み|なぜ「否定したいこと」を立てるのか
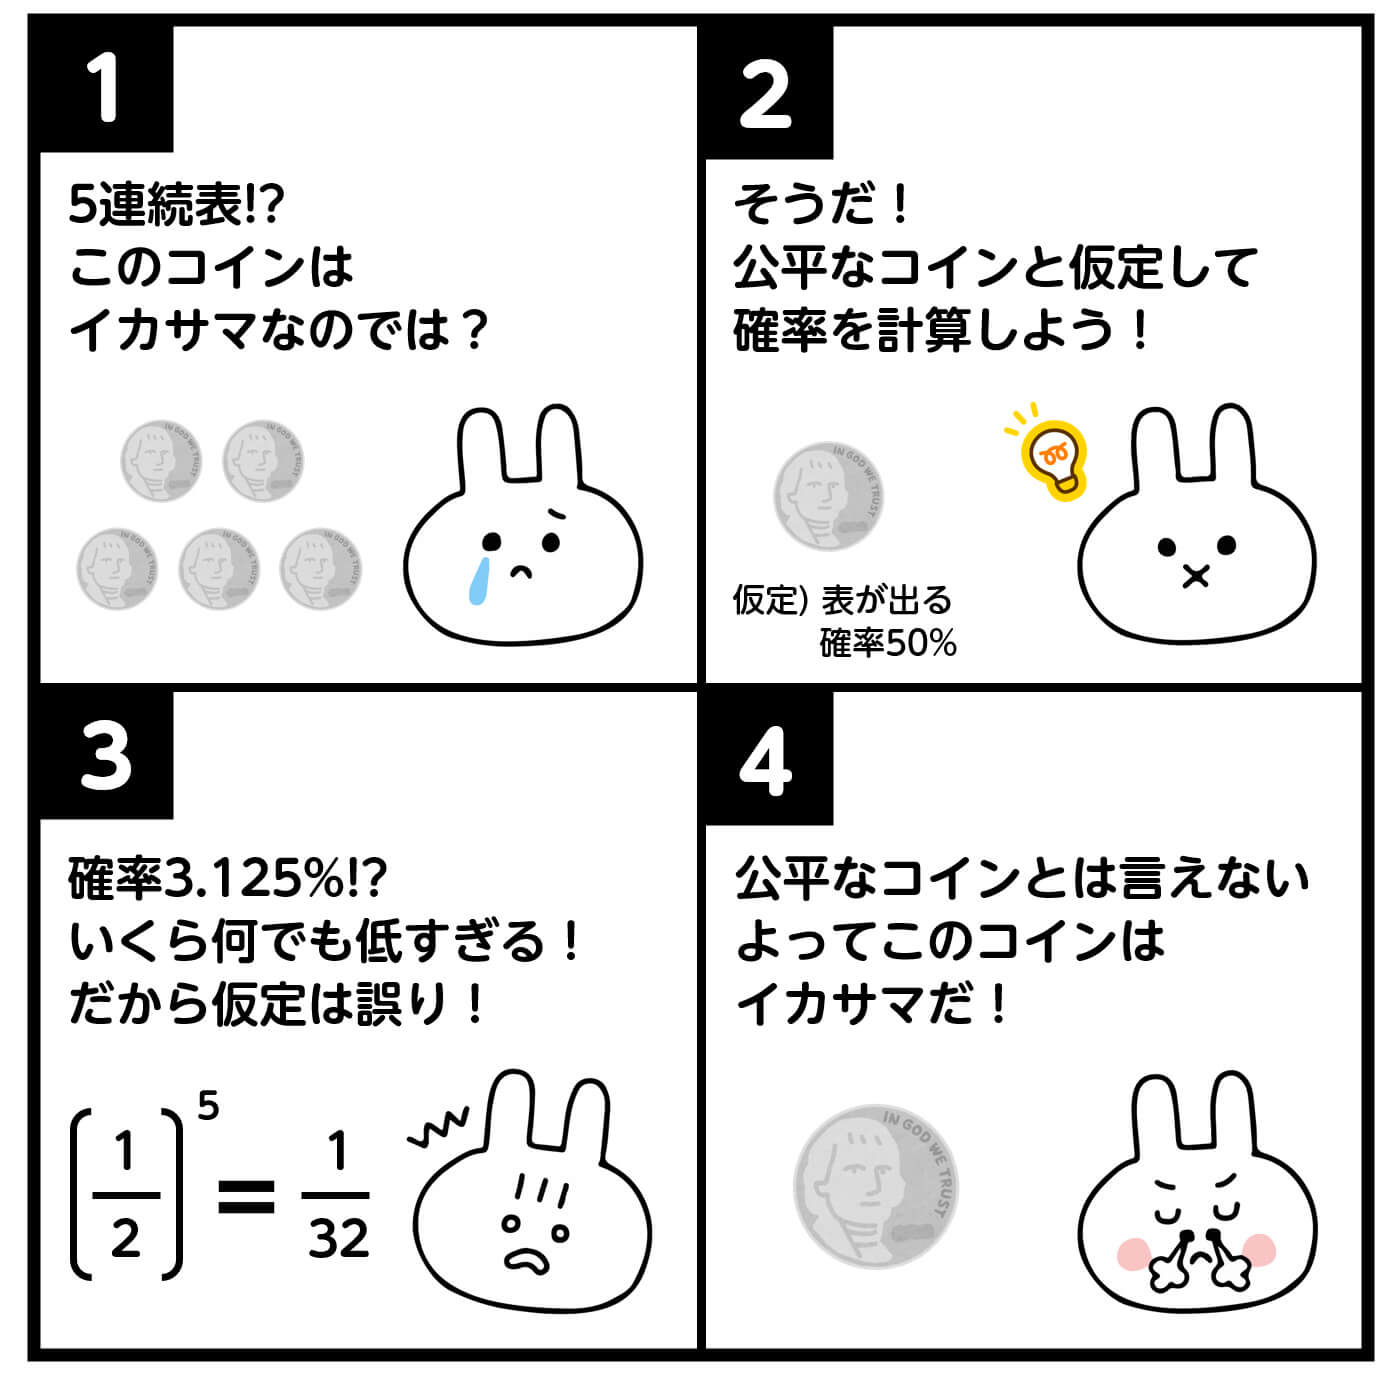
統計的仮説検定を学び始めた人が最初に直面する壁が、帰無仮説(H0)と対立仮説(H1)という独特の立て付けです。日常会話であれば「新デザインのバナーの方がクリック率が高い」とストレートに主張したくなりますが、統計の世界ではあえて遠回りをします。まず「新旧バナーでクリック率に差はない」という仮説を立て、それが確率的に極めて起こりにくいことをデータで示し、その仮説を葬り去る(棄却する)というアプローチをとります。
この手法は、数学における「背理法」や裁判の「推定無罪」と同じ論理構造です。被告人が無罪であると仮定したとき、あまりにも不自然な証拠が積み上がれば無罪の前提を捨てて有罪を下すように、統計でも「偶然にしては出来過ぎている」レベルのデータを突きつけることで、本来証明したい対立仮説を採択します。「統計的仮説検定をわかりやすく解説してほしい」と頼まれた際、私はいつも「否定したい仮説をあえて土俵に上げ、データという証拠でノックアウトする手法」と説明しています。
ここで注意すべきは、帰無仮説が棄却できなかった場合の解釈です。検定結果が「差があるとは言えない」となった場合、それは「差がないことが証明された」わけではありません。単に「手元のデータからは差があると言い切るだけの十分な証拠が集まらなかった」に過ぎず、この微妙なニュアンスの違いを取り違えると実務で手痛い判断ミスを招きます。
【判断の境界線】有意水準とP値の目安|両側検定と片側検定の使い分け
検定結果をジャッジする決定打となるのが有意水準(α)とP値(有意確率)の関係です。P値とは、「もし帰無仮説が正しい(差がない)としたら、今回観測されたデータ、あるいはそれ以上に極端なデータが得られる確率はどれくらいか」を表す数値です。このP値が、事前に設定した基準である有意水準を下回ったとき、「偶然とは考えにくい」として有意差を認めます。
実務や学術研究における有意水準の目安としては5%(0.05)または1%(0.01)が標準的に用いられます。しかし、この数値を分析結果が出た後に都合よく変更することは禁じ手です。結果を見てから「P値が0.04だから5%基準を採用しよう」とする行為は、科学的な公正さを著しく損なう危険な操作にほかなりません。
また、検証の方向性によって両側検定と片側検定の違いを意識する必要があります。「新薬と既存薬で効果が異なるか」を調べる場合は正負両方の変化を考慮する両側検定を用いますが、「新薬のほうが優れていること」だけを検証したい明確な理論的裏付けがある場合は片側検定を選択します。片側検定のほうが帰無仮説を棄却しやすくなりますが、裏を返せば「悪化したケース」を想定外として切り捨てるリスクを孕むため、ビジネスの実務では保守的な両側検定を原則とするのが安全策です。
【初心者が陥る罠】第1種の過誤と第2種の過誤|ビジネスを揺るがす判断ミス
検定の仕組みを理解する上で避けて通れないのが、避けることのできない「2つの誤り」です。現実世界に100%の確実性は存在しないため、どんなに精緻な分析を行っても確率的なエラーが発生します。
1つ目が第1種の過誤(αエラー)です。これは「本当は差がないのに、誤って差があると判定してしまうミス」を指します。無罪の人を有罪にしてしまう冤罪のようなもので、新機能に効果がないのに「効果あり」と判断して無駄な開発投資を続けてしまうケースが該当します。有意水準を厳しく(5%から1%へ)設定すれば、この誤りを減らすことができます。
一方、見落とされがちなのが第2種の過誤(βエラー)です。これは「本当は差があるのに、差を見逃してしまうミス」を意味します。真犯人を無罪放免にしてしまう過誤であり、実は有望だった新施策を「有意差なし」として捨て去ってしまう機会損失につながります。この第2種の過誤を犯さない確率を検出力(1 - β)と呼び、通常は0.8(80%)以上を確保することが望ましい設計とされます。
棄却域と検出力の求め方を理解すると分かりますが、αとβはトレードオフの関係にあります。αエラーを恐れて判定基準を厳しくしすぎると、棄却域が狭まり、結果としてβエラーが跳ね上がって有望な施策を見落とします。自社のビジネスにおいて「冤罪のコスト」と「見逃しのコスト」のどちらが致命的かを天秤にかけ、適切なバランスを見定める姿勢こそが分析官の腕の見せ所です。
【実務の代表格】t検定とカイ二乗検定の具体例|データ型に応じた使い分け
現場で実際に使われる検定手法は多岐にわたりますが、まず押さえるべき双璧がt検定とカイ二乗検定です。どちらを使うべきかは、扱っているデータの性質(量的データか質的データか)によって綺麗に分かれます。
平均値の差を検証したいときに活躍するのがt検定です。たとえば、新しいWebサイトレイアウトによって「ユーザーの平均滞在時間(連続変数)」が伸びたかを比較する場合が典型例です。t検定の具体例と手順としては、まず2つの群のデータが独立しているか(別々のユーザーか、同一人物の前後比較か)を確認し、等分散性の確認を経て検定統計量t値を算出、自由度に応じた分布からP値を導き出します。
これに対し、割合や頻度の偏りを検証するツールがカイ二乗検定です。A/Bテストにおける「購入ボタンのクリック率(クリックした/しないのカテゴリ変数)」の比較や、アンケート結果のクロス集計表の分析にはカイ二乗検定の活用法が最適解となります。期待度数(もし差がないとしたら得られるはずの理論上の人数)と、実際に観測された度数とのズレの大きさをカイ二乗値として算出し、その偏りが偶然の範囲を超えているかを判定します。
【グループ比較の壁】分散分析と多重比較|安易な検定の繰り返しを防ぐ
実務で頻繁に目にする危険なアンチパターンが、「3つ以上のグループを比較する際に、2群間のt検定を何回も繰り返す」という行為です。例えばA案・B案・C案の広告バナーの効果を比べる際、A対B、B対C、A対Cと3回のt検定を行ってしまうと、多重性の問題が発生します。
有意水準5%の検定を3回繰り返した場合、少なくとも1回以上「本当は差がないのに偶然有意差が出てしまう確率」は、1 - (1 - 0.05)^3 ≒ 約14.3%まで跳ね上がります。比較する群が増えれば増えるほど、嘘の有意差(第1種の過誤)を掴まされる確率は雪だるま式に膨らんでいくのです。
この罠を回避するために用いられるのが分散分析(ANOVA)です。分散分析は、グループ全体のばらつきとグループ内のばらつきの比率(F値)を見ることで、「全体のどこかに有意な差が存在するか」を一度の検定で判定します。そして、分散分析で有意差が確認された後に初めて、テューキー法(Tukey-Kramer法)やボンフェローニ補正といった多重比較の手続きを踏み、どのペアとどのペアの間に真の差があるのかを特定するのが統計学的に正しいアプローチです。
【2026年最新現場】サンプルサイズと有意差の罠|効果量で見るべき真実
現代のビッグデータ環境下において、最も警戒すべき落とし穴がサンプルサイズと有意差の乖離です。統計学の数理上、サンプルサイズ(データ数)を極限まで増やせば、どんなに微小で無意味な差であってもP値はゼロに近づき、統計的有意差として検出されてしまいます。
月間数百万PVを誇る大規模ECサイトのA/Bテストで、購入率が「10.00%」から「10.02%」へわずか0.02ポイント上昇したとします。サンプルサイズが数百万件あれば、検定結果は「P < 0.001」となり、文句なしの有意差を示すでしょう。しかし、この0.02%の改善のために多額のシステム改修費を投じる価値があるのかという点は、統計学ではなく事業判断の領域です。
こうした事態を防ぐため、仮説検定の実務での注意点として定着しているのが「効果量(Effect Size)」の併記です。P値が「差が存在する確率の確かさ」を示す指標であるのに対し、効果量(Cohen's dなど)は「その差が現象としてどれくらい大きいか」をデータ規模に依存せず客観的に表します。現代の意思決定においては、「P値が小さく、かつ効果量が実務上の採算ラインを超えているか」という二段構えの検証がスタンダードとなっています。こうした本質的な理解は、実務のみならず統計WEB検定対策をはじめとする各種資格試験の応用問題でも決定的な差をつけるポイントです。
【統計的仮説検定】に関するよくある質問(FAQ)
Q1:P値が0.05を下回れば、対立仮説が「100%正しい」と証明されたことになりますか?
A1:いいえ、100%の証明にはなりません。P値が0.03であれば、「帰無仮説が正しいと仮定したとき、このような極端なデータが得られる確率が3%しかない」ことを意味するに過ぎず、5%基準であっても20回に1回は「本当は差がないのに偶然差が出た」という第1種の過誤が発生します。統計的検定は絶対的な真理の確定ではなく、不確実性をコントロールしながら判断を下すための確率的ツールです。
Q2:実務で検定を行う際、サンプルサイズは事前にどう決めるべきですか?
A2:分析を始める前に「検出力分析(パワーアナリシス)」を行い、必要なサンプルサイズを設計するのが理想的です。ビジネス上検出したい「最小限の意味ある差(効果量)」、許容するαエラー(通常5%)、期待する検出力(通常80%)の3要素を固定することで、過不足のない適正なサンプルサイズを逆算できます。データが少なすぎて有意差を見落とすことも、多すぎて無意味な微差に振り回されることも防げます。
Q3:統計検定などの試験対策と、ビジネス実務での検定利用で最も意識すべきギャップは何ですか?
A3:試験対策では数式の展開や検定統計量の正確な算出、棄却域の読み取りが重視されますが、実務では「そもそもデータが前提条件(正規性や等分散性、独立性)を満たしているか」の確認と、「統計的有意差がビジネス上のインパクト(実質的有意性)を伴っているか」の解釈が成否を分けます。ツールが計算を肩代わりしてくれる現代だからこそ、前提条件の妥当性と効果量の評価にリソースを割く姿勢が求められます。
まとめ:数字の「有意差」に踊らされず本質を見抜くデータリテラシーを
統計的仮説検定は、感情や直感に左右されがちなビジネスの議論において、客観的でブレない羅針盤となってくれる強力なフレームワークです。しかし、その強力さゆえに、P値の過信や過誤の無視といった「道具に使われる側」のミスを犯すと、誤った戦略へと組織を誘導する凶器にもなり得ます。
帰無仮説の論理構成を正しく理解し、第1種・第2種の過誤を天秤にかけ、効果量とサンプルサイズのバランスに目を配ること。数字の背後にある文脈まで深く読み解く確かなリテラシーを武器に、不確実な未来を切り拓く精度の高い意思決定を積み重ねていきましょう。 (出典: 統計 的 仮説 検定(Yahoo!ニュース))


テクノロジーやライフスタイル領域を中心に執筆活動を行っています。趣味は写真撮影と旅行です。
