0と1が文字に変わる仕組み!二進数と文字コード変換の全技術
映画のサイバー攻撃シーンやプログラミングの現場で見かける「01000001」といった数字の羅列。コンピュータの内部では、あらゆるテキストや画像、動画がすべて「0」と「1」の二進数(バイナリデータ)として処理されています。一見すると意味不明な暗号のように見えますが、明確な変換ルールさえ把握すれば、人間でも簡単に元の文章を読み解くことが可能です。
英語のアルファベットから複雑な日本語の漢字まで、デジタル端末がどのように二進数を認識して画面に文字を出力しているのか、その変換メカニズムを紐解きます。手作業での解読手順から、WebツールやExcel、Pythonを用いた自動変換テクニックまで詳しく解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:二進数から文字への変換は「8ビット(1バイト)ごとに区切って文字コード表と照合する」のが基本原則。
- 要点2:英数字は「ASCII(アスキーコード)」、日本語は「UTF-8」などの文字コード規格によって0と1の並びが厳密に定義されている。
- 要点3:手計算だけでなく、Webの変換ツールやExcel関数、Pythonを活用すれば大量のバイナリデータも一瞬でテキスト化可能。
【基礎知識】0と1の羅列が文字になる仕組み|8ビット・1バイトの基本ルール
コンピュータの頭脳であるCPUやメモリは、電圧の高低(オン・オフ)という2つの状態しか判別できません。このスイッチのオン・オフを数値化したものが「1」と「0」であり、これが二進数(バイナリ)と呼ばれるデータの最小単位です。
二進数の1桁を「1ビット(bit)」と呼びます。1ビットでは「0」か「1」の2通りしか表現できませんが、これを8つ束ねた「8ビット=1バイト(Byte)」にすることで、2の8乗である256通り(0〜255)の数値を表現できるようになります。コンピュータはこの256通りの数値の1つひとつに特定の文字を割り当てることで、文章をデータとして記録・処理しています。
文字を二進数に置き換えることを「エンコード(符号化)」、反対に二進数のデータを文字へと戻す処理を「デコード(復号)」と呼びます。バイナリとテキストの相互変換は、すべてのデジタル通信の根幹を支える基盤技術です。
【実践手順】二進数から文字コードへの変換プロセス|アスキーコードと10進数・16進数の関係
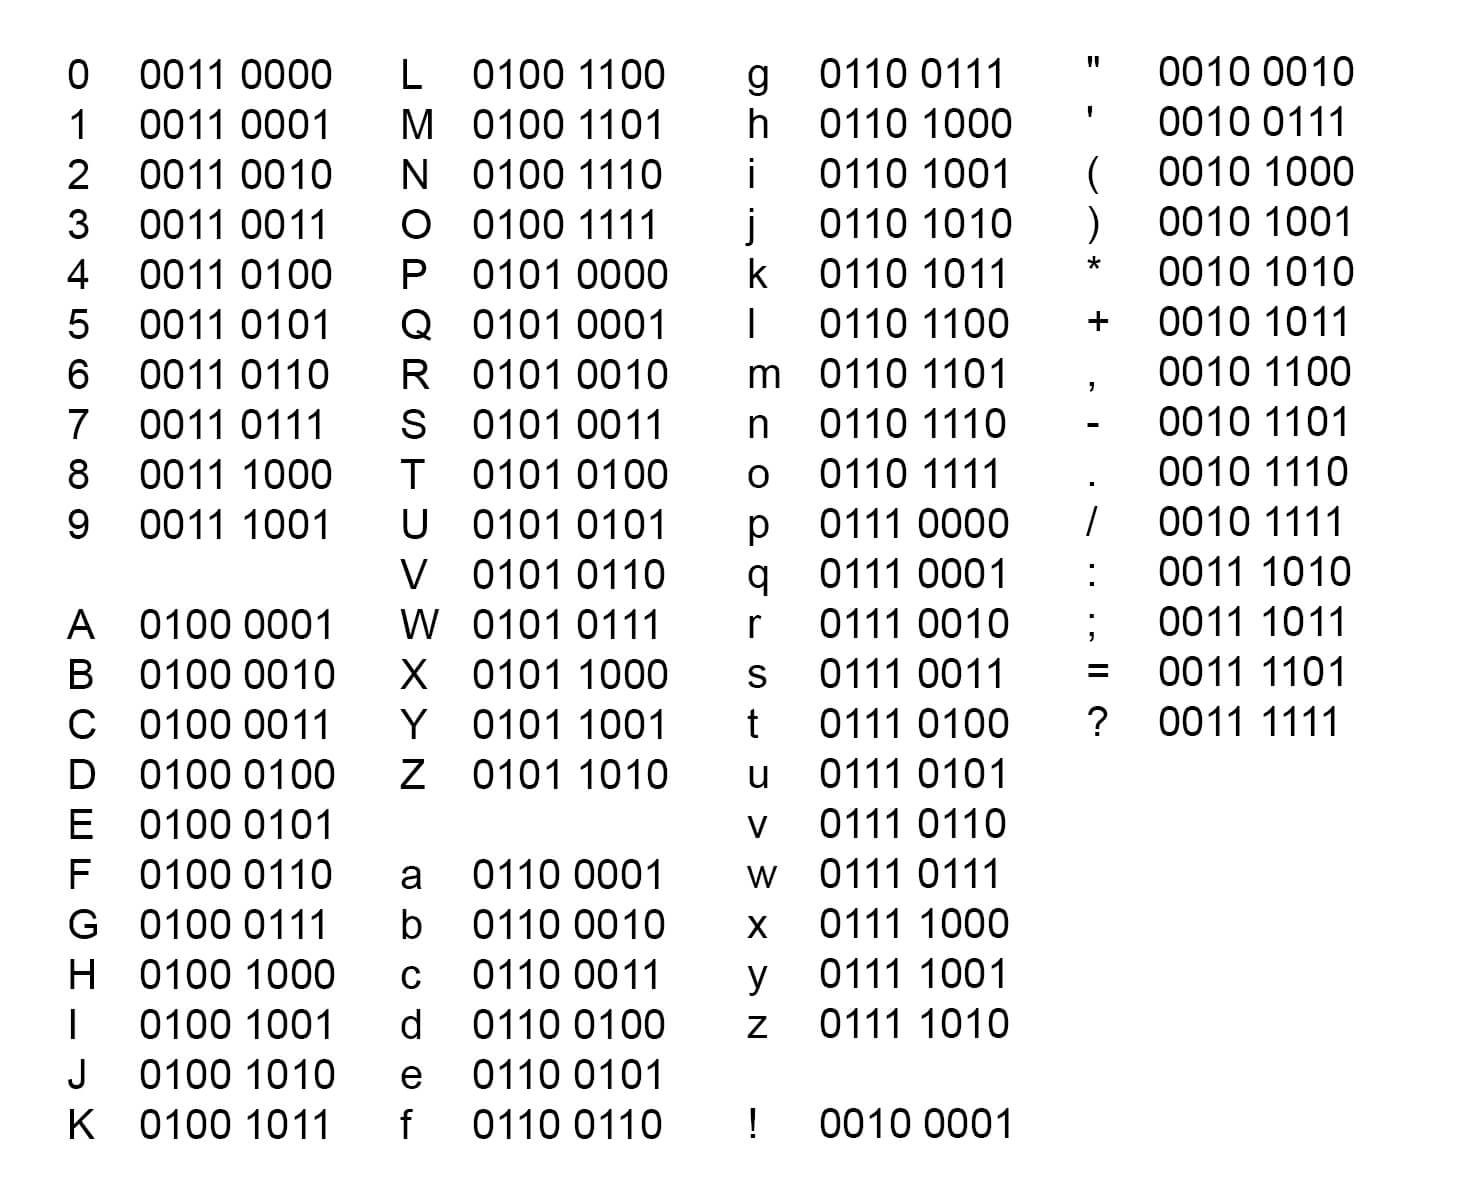
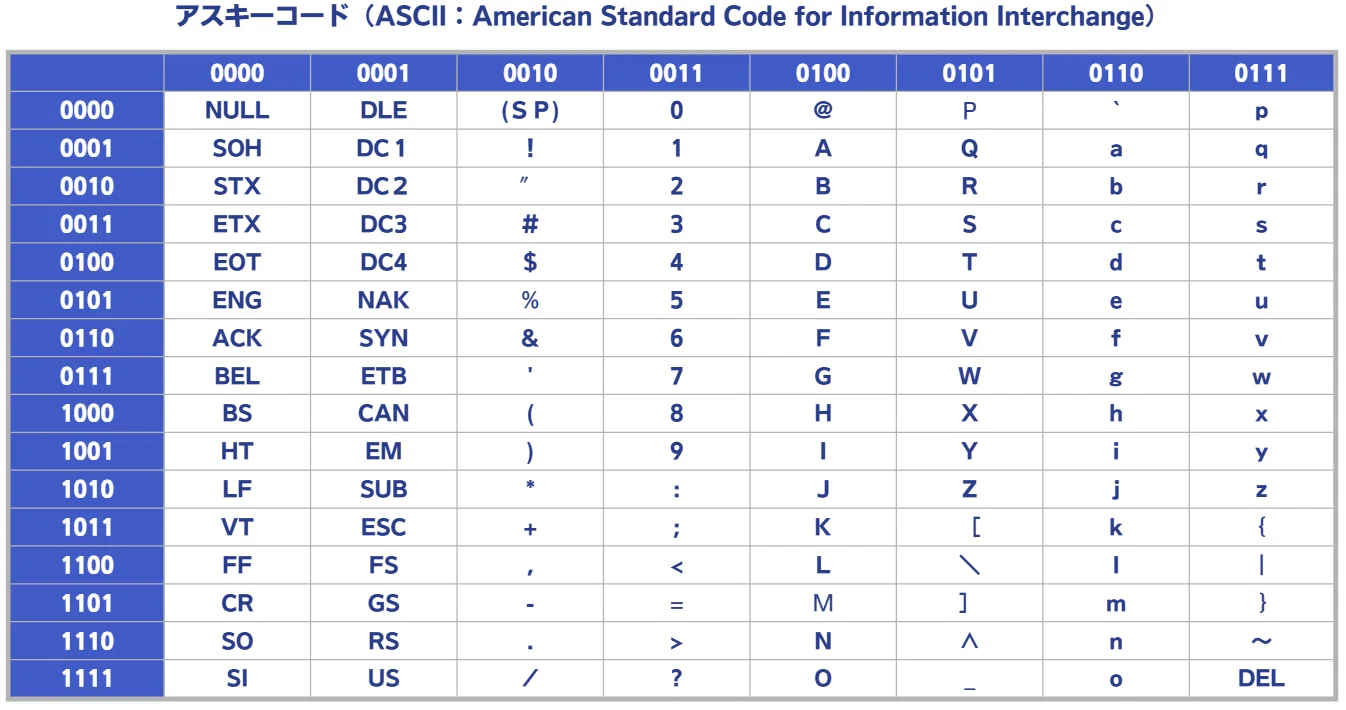
実際に二進数のデータを文字へと変換する際、世界標準として広く使われているのがアスキーコード(ASCII)です。ASCIIは半角英数字や記号、制御文字などを7〜8ビットで定義した文字コード規格です。
変換の手順は以下の3ステップで進めます。
ステップ1:二進数を8桁(1バイト)ずつに区切る
例えば「0100100001101001」というデータがある場合、まずは8桁ごとに「01001000」と「01101001」に分割します。
ステップ2:二進数を10進数(または16進数)に変換する
各桁の重み(128, 64, 32, 16, 8, 4, 2, 1)を足し合わせます。
・01001000 = 64 + 8 = 72(16進数表記:0x48)
・01101001 = 64 + 32 + 8 + 1 = 105(16進数表記:0x69)
ステップ3:アスキーコード表で該当する文字を探す
ASCIIコード表を参照すると、10進数の「72」はアルファベット大文字の「H」、10進数の「105」は小文字の「i」に対応しています。この結果、元のバイナリデータは「Hi」という文字列であることが判明します。
二進数のままでは桁数が多すぎて人間が直感的に扱いにくいため、エンジニアの間では4ビットを1桁で表せる16進数(Hex)を介して変換作業を行うケースが一般的です。
【日本語の壁】UTF-8の仕組みと二進数で漢字・ひらがなを表現する方法
アルファベット中心の英語圏であれば1バイト(256通り)で十分収まりますが、ひらがな・カタカナ・漢字を無数に持つ日本語を表現するには容量が足りません。そこで登場したのが、世界中のあらゆる文字を収録した共通規格「Unicode」と、それを効率よくバイナリに変換するエンコード方式「UTF-8」です。
UTF-8では、文字の種類に応じてデータ長を1バイトから最大4バイトまで動的に変化させる「マルチバイト文字」の仕組みを採用しています。英数字は従来のASCIIと同じ1バイトで表現し、日本語のひらがなや一般的な漢字の多くは3バイト(24ビット)を使って表現します。
例えば、ひらがなの「あ」をUTF-8で二進数に変換すると、以下の3バイト構造になります。
11100011 10000001 10000010(16進数表記:E3 81 82)
先頭バイトの「1110」は「この文字は3バイト構成である」ことを示す識別フラグであり、後続のバイトの先頭にある「10」は「前のバイトから続くデータである」ことを表す制御パターンです。残りのビット部分に文字固有のデータが格納されています。Webページやアプリで日本語が正しく表示される背景には、こうした精緻なビット配置のルールが存在します。
【便利ツール&実践】Web変換ツール・Excel・Pythonでの自動変換テクニック
短い文字列であれば手作業での計算も可能ですが、長文や複雑な日本語データを扱う場合は自動化ツールを活用するのが効率的です。
1. Webの無料変換ツールを使う
ブラウザ上で「2進数 文字 変換 ツール」や「バイナリ テキスト コンバーター」と検索すると、入力欄に0と1を貼り付けるだけで瞬時にテキスト化してくれるWebサービスが多数見つかります。UTF-8やShift_JISなど、文字コードを指定して変換できるツールを選ぶと文字化けのトラブルを防げます。
2. Excelを活用した関数による変換
Excelのセル上で二進数を文字へ戻す場合、標準関数を組み合わせて処理します。
例えば、セルA1に8桁の二進数「01000001」が入力されている場合、以下の数式で文字「A」を出力できます。
=CHAR(BIN2DEC(A1))
BIN2DEC関数で二進数を10進数の「65」へ変換し、CHAR関数でその数値をASCIIコードに対応する文字へ変換する構造です。
3. Pythonによるスマートな一括変換
プログラミング言語のPythonを使えば、スペース区切りの二進数文字列や日本語のバイナリデータも数行のコードで復元できます。
ASCII(英数字)の二進数を変換する例:
binary_data ="01010000 01111001 01110100 01101000 01101111 01101110"
 text = ''.join([chr(int(b, 2)) for b in binary_data.split()])
 print(text) # 出力結果: Python
UTF-8(日本語)の二進数を変換する例:
# 「あ」のバイナリデータ
 binary_list = ["11100011", "10000001", "10000010"]
 byte_data = bytes([int(b, 2) for b in binary_list])
 print(byte_data.decode('utf-8')) # 出力結果: あ
【謎解き・セキュリティ】二進数メッセージの暗号解読法とバイナリ解析のコツ
謎解きゲームやセキュリティ競技(CTF)、あるいはミステリー作品の暗号として提示される二進数メッセージを解読するには、いくつかの決まった着眼点があります。
1. 全体の桁数をカウントする
スペースがない連続した数字の羅列を見たときは、まず全体の文字数を数えます。もし総桁数が「8の倍数」になっていれば、8ビット(1バイト)ごとに区切ることで英数字の文章が現れる可能性が極めて高いと判断できます。
2. 先頭のパターンを観察する
ASCIIコードにおける半角アルファベットは、二進数で表した際に特徴的な規則性を持ちます。
・大文字(A〜Z):0100xxxx(0100で始まる)
・小文字(a〜z):0110xxxx または 0111xxxx(011で始まる)
データ群の中に「010」や「011」から始まる8桁のブロックが頻出している場合、通常の英文テキストがそのまま二進数化されている有力な証拠です。
3. 逆変換で確認する
自分で二進数の暗号を作成したい場合は、文字を10進数のアスキーコードへ変換し、それを2で割り続けて余りを並べることで二進数列を生成できます。仕組みを双方向から体験することが、バイナリ解析の理解を深める最短ルートです。
【二進数の文字変換】に関するよくある質問(FAQ)
Q1:スペースのない長い二進数はどうやって区切ればいいですか?
A1:英数字テキストの場合、基本的に8桁(1バイト)ごとに左から順番に区切ります。例えば「0100000101000010」であれば「01000001(A)」と「01000010(B)」に分割します。もし全体の桁数が8の倍数にならない場合は、先頭の「0」が省略されていないか確認してください。
Q2:変換ツールを使っても意図しない記号や文字化けが出る原因は?
A2:変換元のデータが想定と異なる文字コード(UTF-8、Shift_JIS、EUC-JPなど)でエンコードされていることが主な原因です。また、7ビット区切りの古いASCIIデータや、Base64などの別形式を経由しているデータも文字化けを引き起こします。設定側の文字コード形式を変更して再試行してください。
Q3:なぜエンジニアは二進数だけでなく16進数を頻繁に使うのですか?
A3:二進数は桁数が長くなりすぎて人間にとって視認性が悪いためです。16進数は「0〜9」と「A〜F」の16文字を使い、二進数の4ビット分をちょうど1文字で表現できます。1バイト(8ビット)をわずか2文字(例: 11111111 → FF)で簡潔に記述できるため、メモリ番地やカラーコード、データ解析の現場で多用されます。
まとめ:バイナリの仕組みを理解してデジタルデータを思い通りに操る
ディスプレイに映し出されるあらゆるテキストの正体は、緻密なルールに基づいて配置された0と1の電気信号です。「8ビット=1バイト」という基本単位と、ASCIIやUTF-8といった文字コードの対応関係さえ掴んでしまえば、複雑に見えるバイナリデータも論理的に読み解くことができます。
Webツールでの手軽な変換から、ExcelやPythonを使った自動処理まで、用途に合わせて最適な手法を選択してください。コンピュータの最深部で動くデータの原理を知ることは、プログラミングやデータ解析、セキュリティ知識を深める上での大きな武器となります。 (出典: 二 進数 文字 変換(Yahoo!ニュース))

毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。
