条件付き期待値の公式と性質を完全攻略!直感理解からタワー性まで解説
データサイエンスや機械学習の数理基盤を学ぶ過程で、多くの学習者が最初に激しい挫折感を味わうハードルが「条件付き期待値」です。「条件付き確率の計算まではスムーズに理解できたのに、大文字の確率変数 $Y$ で条件付けられた途端、数式が何を意味しているのか見失ってしまった」という声は後を絶ちません。2026年の現在、生成AIモデルの内部数理やファイナンスの確率微分方程式を読み解く上でも、この概念の確実な習得は避けて通れない必須教養となっています。
条件付き期待値は、一見すると抽象的で難解に見えますが、本質は「手元にある情報(既知のデータ)を踏まえて、未知の値をいかに合理的に推測・要約するか」という極めて自然な思考法に基づいています。本稿では、条件付き確率の基礎的な復習から、離散型・連続型の厳密な定義、タワー性(平滑化性)などの重要性質、さらには具体的な計算例題までを一本のストーリーとして徹底的に紐解きます。
📌 【この記事の重要ポイントまとめ】
- 要点1:条件付き期待値 $E[X|Y]$ の正体は単一の数値ではなく、情報 $Y$ の値に応じて変化する「条件付き確率変数($Y$ の関数)」である。
- 要点2:反復期待値の法則とも呼ばれる「タワー性(平滑化性)」を理解すれば、多次元の複雑な確率モデルを驚くほどシンプルに分解して処理できる。
- 要点3:機械学習の回帰分析における理論的最適解(最小二乗推定量)やファイナンスの「マルチンゲール理論」は、すべて条件付き期待値の性質を土台に構築されている。
【つまずき解消】条件付き期待値とは?直感的イメージと定義の壁を突破する
「条件付き期待値の計算や公式でつまずいていませんか?」という疑問に対し、数学教育の現場から聞こえてくる最大の原因は、「条件付き期待値を特定のスカラー(固定された数値)だと思い込んでいること」にあります。この誤解を解く第一歩として、まずは条件付き確率と全確率の法則を起点にした直感的な整理から進めましょう。
通常の期待値 $E[X]$ は、確率変数 $X$ が取り得る値の「全体の平均」であり、計算結果はただ1つの確定した実数になります。一方で、「ある事象 $B$ が発生した」という前提を置いた場合の期待値 $E[X|B]$ も、事象 $B$ に絞った平均値ですから、これ自体は数値です。しかし、条件部分に事象ではなく別の確率変数 $Y$ を据えた $E[X|Y]$ は、全く異なる性質を帯びます。これが条件付き確率変数と呼ばれる所以です。
たとえば、「明日の気温を $X$」「今夜の天候を $Y$(晴れ、曇り、雨)」としましょう。「晴れ」と分かった上での気温の期待値は25度、「雨」と分かった上での気温の期待値は18度といったように、手に入る情報 $Y$ の中身によって期待値そのものが変化します。つまり、$E[X|Y]$ とは「情報 $Y$ をインプットすると、その条件下での $X$ のベストな予測値を返す関数 $g(Y)$」に他なりません。この「変数を入力すると値が決まる確率変数」という視点こそが、抽象的な記号の海で溺れないための命綱となります。
ここから、数学的な条件付き期待値 定義を離散型と連続型に分けて確認します。
1. 離散型確率変数の定義
確率変数 $X, Y$ が離散型であり、同時確率質量関数を $P(X=x, Y=y)$、$Y$ の周辺確率を $P(Y=y)$ とするとき、$Y=y$ が与えられた下での $X$ の条件付き確率は $P(X=x | Y=y) = \frac{P(X=x, Y=y)}{P(Y=y)}$ です。このとき、条件付き期待値は次のように定義されます。
$$E[X | Y=y] = \sum_{x} x \, P(X=x | Y=y)$$
そして、$Y=y$ という具体的な実現値ではなく、確率変数 $Y$ そのものを条件とした $E[X|Y]$ は、標本空間上で値 $E[X|Y=y]$ を取る確率変数として厳密に扱われます。
2. 連続型確率変数の定義
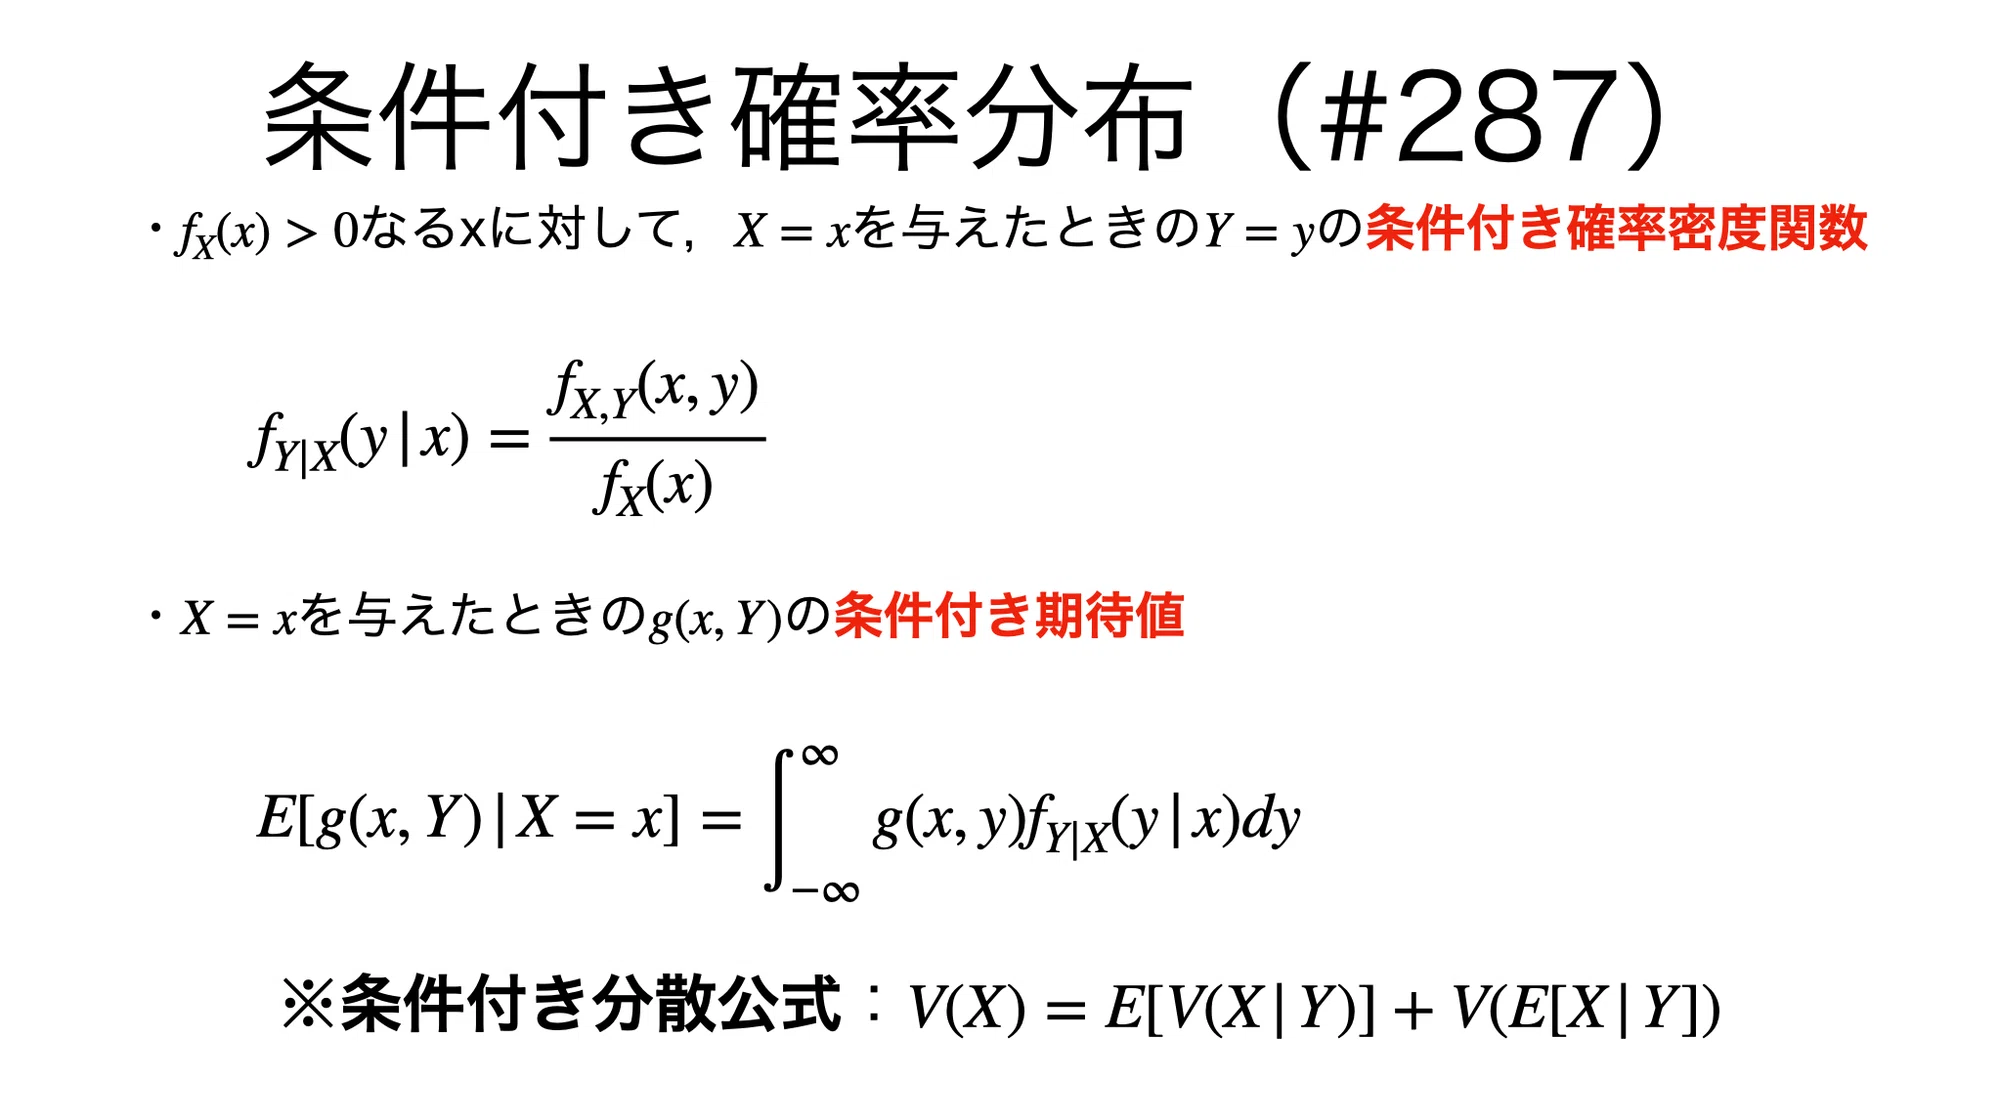
確率変数 $X, Y$ が連続型で、同時確率密度関数 $f_{X,Y}(x,y)$ および $Y$ の周辺確率密度関数 $f_Y(y)$ を持つ場合、条件付き確率密度関数は $f_{X|Y}(x|y) = \frac{f_{X,Y}(x,y)}{f_Y(y)}$ と表されます。この下での条件付き期待値は、積分を用いて以下のように計算されます。
$$E[X | Y=y] = \int_{-\infty}^{\infty} x \, f_{X|Y}(x|y) \, dx$$
離散型における「シグマ(総和)」が、連続型では「インテグラル(積分)」に置き換わっただけであり、本質的な構造は完全に同一であることが分かります。
【完全網羅】押さえるべき条件付き期待値の重要公式と性質一覧
条件付き期待値が実務や高度な理論で極めて強力な武器となる理由は、計算を劇的に簡略化する美しい数学的性質をいくつも備えているからです。ここでは、試験対策やアルゴリズム理解において絶対に落とせない中核的な性質を整理します。
まず押さえるべきは、通常の期待値と同様に成立する線形性です。定数 $a, b$ に対し、以下の関係が成り立ちます。
$$E[aX_1 + bX_2 | Y] = aE[X_1 | Y] + bE[X_2 | Y]$$
さらに重要なのが、「既知の情報の取り出し(Taking out what is known)」と呼ばれる性質です。すでに $Y$ という情報が与えられている世界において、$Y$ の関数である $h(Y)$ はもはや不確実なランダム変数ではなく「定数」として振る舞います。したがって、次のように外側へ括り出すことができます。
$$E[h(Y)X | Y] = h(Y) \, E[X | Y]$$
そして、確率論全体を見渡しても最重要定理の1つに数えられるのが、条件付き期待値 タワー性(別名:条件付き期待値 平滑化性、反復期待値の法則)です。これは「条件付き期待値の、さらに全体の期待値を取ると、元の単純な期待値に戻る」という性質を指します。
$$E[\, E[X | Y] \,] = E[X]$$
このタワー性は、情報量が異なる $\sigma$-加法族(情報構造)の入れ子関係において、「荒い情報で再度平均化すると、細かい情報は平滑化されて荒い情報側に吸収される」という構造を持つことから「タワー(塔)」と呼ばれています。
期待値だけでなく、ばらつきを評価する条件付き分散(Conditional Variance)も見逃せません。条件付き分散は $V(X|Y) = E[(X - E[X|Y])^2 | Y]$ と定義され、これとタワー性を組み合わせることで、統計学で名高い「分散の分解定理(全分散の法則)」が導かれます。
$$V(X) = E[V(X|Y)] + V(E[X|Y])$$
この公式は、「全体のばらつき $V(X)$ は、『グループ内のばらつきの平均 $E[V(X|Y)]$』と『グループ間の平均値のばらつき $V(E[X|Y])$』の和に綺麗に分解できる」という直観を数式化したものです。機械学習におけるバイアス・バリアンス分解の根幹をなす原理でもあります。
| 公式・性質の名称 | 数式表現 | 直感的な意味・挙動 | 主要な活用分野・重要度 |
|---|---|---|---|
| 線形性 | $E[aX + b | Y] = aE[X|Y] + b$ | 条件付け環境下でも和と定数倍がそのまま保存される | 基礎計算全般(必須度:極高) |
| 既知の取り出し | $E[h(Y)X | Y] = h(Y)E[X|Y]$ | 条件に含まれる既知の情報は定数として外に出せる | 時系列解析・ファイナンス理論 |
| タワー性(平滑化性) | $E[E[X|Y]] = E[X]$ | 条件ごとの平均をさらに全体平均すると元の平均に一致 | 全確率計算・マルチンゲール理論 |
| 独立時の挙動 | $X \perp Y \implies E[X|Y] = E[X]$ | 無関係な情報 $Y$ を与えられても予測値は変わらない | 仮説検定・因果推論 |
| 全分散の法則 | $V(X) = E[V(X|Y)] + V(E[X|Y])$ | 全体の分散を「群内分散の平均」と「群間分散」に分解 | 機械学習モデル評価・ANOVA |
【実戦演習】条件付き期待値の計算問題と例題で解法ステップを掴む
抽象的な公式を頭に入れた後は、具体的な数値を動かして「手で解く感覚」を養うことが理解への最短ルートです。ここでは大学院入試や資格試験(アクチュアリー・統計検定1級)で頻出する、離散型と連続型の条件付き期待値 計算問題をステップ・バイ・ステップで解説します。
例題1:サイコロの出目による二段階試行(離散型)
【問題】
公正な6面のサイコロを1回振り、出た目を $N$ とする。続いて、公正なコインを $N$ 回投げるとき、表が出た回数を $X$ とする。このとき、条件付き期待値 $E[X|N]$ および全体の期待値 $E[X]$ を求めよ。
【解説と解答ステップ】
一見すると $N$ が1から6まで変動するため複雑に見えますが、条件付けの考え方を使えば暗算レベルで処理できます。
- $N=n$ を固定して考える:
コインを投げる回数 $N=n$ が確定している世界では、$X$ は成功確率 $p=0.5$、試行回数 $n$ の二項分布 $B(n, 0.5)$ に従います。二項分布の期待値公式より、$E[X | N=n] = n \times 0.5 = \frac{n}{2}$ です。 - 条件付き確率変数として記述する:
具体的な数値 $n$ を確率変数 $N$ に戻すことで、条件付き期待値が得られます。
$$E[X | N] = \frac{N}{2}$$ - タワー性を適用して $E[X]$ を導出する:
タワー性 $E[X] = E[E[X|N]]$ を用いて、全体の期待値を計算します。
$$E[X] = E\left[\frac{N}{2}\right] = \frac{1}{2} E[N]$$
サイコロの出目の平均値は $E[N] = \frac{1+2+3+4+5+6}{6} = 3.5 = \frac{7}{2}$ です。したがって、
$$E[X] = \frac{1}{2} \times \frac{7}{2} = \frac{7}{4} = 1.75$$
わざわざ $X$ の周辺分布 $P(X=k)$ を複雑なシグマ計算で求めなくても、タワー性を経由するだけで鮮やかに $E[X]$ が導き出せました。
例題2:三角形領域上の連続型確率変数(連続型)
【問題】
2次元の連続型確率変数 $(X, Y)$ の同時確率密度関数が以下で与えられている。
$$f_{X,Y}(x,y) = 8xy \quad (0 \le y \le x \le 1)$$
(その他の領域では $0$)。このとき、$Y=y$ が与えられた下での条件付き期待値 $E[X | Y=y]$ を求めよ。
【解説と解答ステップ】
連続型の場合は、領域の積分範囲に細心の注意を払う必要があります。
- $Y$ の周辺確率密度関数 $f_Y(y)$ を求める:
$y$ を固定し、$x$ について積分します。領域より $x$ の動く範囲は $y \le x \le 1$ です。
$$f_Y(y) = \int_{y}^{1} 8xy \, dx = 8y \left[ \frac{x^2}{2} \right]_{y}^{1} = 4y(1 - y^2) \quad (0 \le y \le 1)$$ - 条件付き確率密度関数 $f_{X|Y}(x|y)$ を導出する:
$$f_{X|Y}(x|y) = \frac{f_{X,Y}(x,y)}{f_Y(y)} = \frac{8xy}{4y(1 - y^2)} = \frac{2x}{1 - y^2} \quad (y \le x \le 1)$$ - 条件付き期待値の積分を実行する:
定義に従い、$x$ に条件付き密度を掛けて積分します。
$$E[X | Y=y] = \int_{y}^{1} x \, f_{X|Y}(x|y) \, dx = \int_{y}^{1} x \left( \frac{2x}{1 - y^2} \right) dx = \frac{2}{1 - y^2} \int_{y}^{1} x^2 \, dx$$
$$= \frac{2}{1 - y^2} \left[ \frac{x^3}{3} \right]_{y}^{1} = \frac{2}{1 - y^2} \cdot \frac{1 - y^3}{3}$$
因数分解の公式 $1 - y^3 = (1 - y)(1 + y + y^2)$ および $1 - y^2 = (1 - y)(1 + y)$ を適用して約分すると、次の美しい解答が得られます。
$$E[X | Y=y] = \frac{2(1 + y + y^2)}{3(1 + y)}$$
計算結果に $y$ が残っている点に注目してください。まさに「$Y$ の値に応じて変化する関数」として条件付き期待値が出現している事実が、視覚的にも実感できるはずです。

【実態検証】学習者の生の声と現場目線で見えたリアルなつまずきポイント
国内の数理コミュニティや質問投稿サイト(Yahoo!知恵袋、OKWAVE、専門フォーラム)に寄せられる膨大な相談を定性分析すると、条件付き期待値に対する学習者の苦悩には、明確な共通パターンが存在することが浮き彫りになります。
最も典型的な叫びが、「大文字と小文字の表記揺れで頭が混乱する」という問題です。教科書によって $E[X|Y]$ と書かれていたり、$E[X|Y=y]$ と書かれていたり、時には $E_Y[E_X[X|Y]]$ のように添字が乱舞します。現役の理系大学生やリスキリング中の社会人エンジニアからは、「$E[X|Y=y]$ は単なる数値($y$ を固定したスカラー)なのに、大文字の $E[X|Y]$ になった瞬間に『確率変数だから分散を持つ』と言われて完全に思考停止した」という証言が多数確認されます。
さらに、大学の数学科や計量経済学の専攻生を待ち受けるのが、「測度論的確率論へのステップアップに伴う断絶」です。初等確率論では上記のように「条件付き確率密度で割る」という操作で定義できますが、連続確率変数において「特定の一点 $P(Y=y) = 0$」となる事象で割ることは初等数学のルール違反(ゼロ除算)となります。この矛盾を解消するために導入される「$\sigma$-加法族 $\mathcal{G}$ による条件付け $E[X|\mathcal{G}]$」や「ラドン・ニコディムの定理」を目にした瞬間、直感的なイメージが崩壊し、脱落してしまう学習者が後を絶ちません。
現場指導を行う教育関係者は、「最初から測度論の抽象論に踏み込みすぎず、『$E[X|Y]$ は、$Y$ という情報を使って $X$ を二乗誤差最小で近似した回帰関数である』という幾何学的・統計的な解釈をまず強固に定着させることが、挫折を防ぐ最大の防壁になる」と証言しています。
一般に知られていない盲点とネットの誤解|マルチンゲールへの架け橋
ネット上の簡易解説記事などで頻繁に見られる危険な誤解に、「条件付き期待値は、単に事後確率を使った重み付き平均に過ぎない」という矮小化があります。しかし、現代数学において条件付き期待値が真価を発揮するのは、静止した平均値の計算ではなく、時間の経過に伴う情報の更新プロセス(情報増大系・フィルトレーション)を記述する場面です。
その代表例が、現代数理ファイナンスや確率過程論の主役であるマルチンゲール(Martingale)です。確率過程 $\{X_t\}$ において、時刻 $s$ までのすべての情報(情報履歴 $\mathcal{F}_s$)が与えられた下での将来の時刻 $t$($t > s$)の条件付き期待値が、現在の値 $X_s$ と完全に一致するとき、その過程をマルチンゲールと呼びます。
$$E[X_t | \mathcal{F}_s] = X_s \quad (t > s)$$
これは直感的には「過去から現在までのあらゆる変動履歴を考慮しても、将来の予測値は現在の価格そのものであり、どちらかに偏った儲け(裁定機会)は期待できない」という公平な賭け(効率的市場仮説)を数学的に定式化したものです。もし条件付き期待値という厳密な枠組みがなければ、金融市場におけるオプション価格理論(ブラック・ショールズ方程式)も、2026年現在のAIによる高頻度アルゴリズム取引のリスク管理も、理論的根拠を完全に失ってしまいます。
また、機械学習の理論において「直交射影」としての性質を持つことも見落とされがちな盲点です。自乗誤差損失 $E[(X - g(Y))^2]$ を最小化する任意の可測関数 $g(Y)$ を探す問題の厳密な数学的最適解は、他ならぬ条件付き期待値 $g(Y) = E[X|Y]$ になります。つまり、最小二乗法による回帰分析とは、本質的に「条件付き期待値という理論上の真の関数を、手元のデータから近似的に復元しようとする試み」に過ぎないのです。
【プロの結論】条件付き期待値を深く学ぶべき人・初等的な理解にとどめるべき人の判断基準
確率論の奥深い世界において、条件付き期待値を「どこまで厳密に学ぶべきか」は、学習者のキャリアや目的によって明確に分かれます。自身のゴールに合致しない過剰な数学的厳密性は、時に学習効率を著しく損なうリスクを孕んでいます。
【深層まで徹底的に学ぶべき人】
- アクチュアリー志望者・金融工学(クオンツ)実務者:測度論に基づく $\sigma$-加法族を用いた条件付け、マルチンゲール理論、伊藤の補題への接続が不可欠です。中途半端な理解では実務のプライシング数理に耐えられません。
- 機械学習の理論研究者・統計モデリングエンジニア:強化学習におけるベルマン方程式の収束証明や、拡散モデル(Diffusion Models)のスコアベース理論を数式レベルで拡張・改善するために、タワー性や射影定理の完全な把握が必須となります。
【初等的な直感理解と公式適用にとどめるべき人】
- データアナリスト・実務のビジネスマーケター:「$E[X|Y]$ は属性 $Y$ ごとのセグメント別平均値である」「分散はグループ内とグループ間に分解できる」という感覚さえ掴んでいれば、分析ツールの活用や意思決定には十分です。測度論の沼に足を取られる必要はありません。
- 大学初年度の教養数学・一般資格の受験者:まずは離散型・連続型の定義式を使った計算問題の反復と、タワー性 $E[E[X|Y]]=E[X]$ を道具として迷わず使える状態を目指すのが最も投資対効果の高い戦略です。

【条件付き期待値】に関するよくある質問(FAQ)
Q1:なぜ条件付き期待値 $E[X|Y]$ は単なる数値ではなく「確率変数」と呼ばれるのですか?
A1:条件部分にある $Y$ 自身が、試行結果によってサイコロのように値を変える「確率変数」だからです。$Y$ が特定の値 $y$ に確定すれば $E[X|Y=y]$ という確定した数値(実数)になりますが、$Y$ の値が定まっていない段階では「$Y$ の結果に応じて値が変動する関数」となるため、数学的に確率変数として扱われます。
Q2:タワー性(平滑化性)はどのような計算場面で最も役に立ちますか?
A2:多重のランダム性が絡む「複合試行」の期待値を求める場面で絶大な威力を発揮します。たとえば「来店客数 $N$ がポアソン分布に従い、各客の購買額 $X_i$ が正規分布に従うときの総売上の期待値」などを計算する際、まず客数 $N$ を固定した条件付き期待値を出し、後から $N$ の平均を取ることで、極めてシンプルに解を導くことができます。
Q3:条件付き分散 $V(X|Y)$ と通常の分散 $V(X)$ はどう違うのですか?
A3:$V(X)$ は事前の情報が何もない状態での $X$ 全体のばらつきの大きさを示します。一方の $V(X|Y)$ は、「$Y$ という情報を手に入れた後でも、なお説明しきれずに残っている $X$ のばらつき(残差の不確実性)」を意味します。全分散の法則 $V(X) = E[V(X|Y)] + V(E[X|Y])$ が示す通り、情報 $Y$ を得ることで通常は不確実性が減少します。
Q4:連続型において、確率ゼロの事象 $P(Y=y)=0$ で条件付けるのは数学的に矛盾しませんか?
A4:初等確率論における極限操作 $\lim_{\epsilon \to 0} P(X \in A | y \le Y \le y + \epsilon)$ として解釈することで矛盾を回避しています。ただし、この方法では極限の取り方によって値が変わる「ボレル・コルモゴロフのパラドックス」が生じるリスクがあります。そのため、現代の厳密な確率論では確率密度で割るのではなく、積分方程式を満たす可測関数として公理的に条件付き期待値を再定義しています。
まとめ:確率論の壁を乗り越え数理モデルを使いこなすために
条件付き期待値は、初学者にとって記号の抽象度が一気に跳ね上がる難所ですが、その本質は「得られた情報を最大限に活用して、対象の最も確からしい姿を推定する」という合理的なアプローチにあります。
単なる数値ではなく「条件によって姿を変える確率変数」という基本像を心に留め、タワー性や既知の取り出しといった代数的な性質を自在に扱えるようになれば、統計学の検定理論から最新の機械学習アルゴリズム、金融工学のプライシング理論に至るまで、視界は劇的にクリアになります。まずは本稿で紹介したサイコロや連続型の例題をご自身の手で一度紙に書き出し、数式が語りかけてくる構造の美しさを体感してみてください。 (出典: 条件 付き 期待 値(Yahoo!ニュース))
最新のトレンドや話題のニュースをわかりやすく解説するWebライターです。読者の皆様に役立つ情報を日々お届けしています。
